🗓️ 公開日: 2026年9月24日 🔄 最終更新日: 2026年9月25日
今回は、Animaで「最高の1枚」を創るための完全攻略バイブルということで、初心者目線に立って僕の持っている知識を余すことなく公開しようと思います。
この記事を読むことで、あなたもAnimaのポテンシャルを100%引き出し、今よりもずっと魅力的で洗練されたイラストを作れるようになります。 少し長いですが、ぜひ最後までお付き合いください。
Animaで必ず気を付けること
特に、SD1.5やSDXLからAnimaに移行してきた方は要注意です。
SDXLはキャラクター、背景、ディテール全体のノイズをバランス良く除去する傾向があるため、画面全体が主役になりがちです。
その結果、「絵の主語がぼやけやすく、主語を際立たせるためにキャラクターのディテールを盛り、Denoiseを上げ、Detailerを何重にもかけまくる……というアプローチになりやすいです。
当然、背景との整合性を取ることが難しくなり、簡易的な背景や白背景という非常にもったいないイラストをよく見かけます。
もちろんすべてのケースに当てはまるわけではありませんが、基本的にSDXLは「盛ってなんぼ」のモデルです。
しかし、その思考のままAnimaで生成を始めると、必ず何度も壁にぶち当たります。
僕自身、SDXLを2年ほど触ってきた移行組です。Animaが出た当初は情報も少なく、何が正解なのか分からないままSDXL時代のやり方でがむしゃらに生成していました。しかし、一向に納得のいくイラストは作れませんでした。たかが一つのアップスケールに、誇張抜きで丸1ヶ月思い悩んだことすらあります。
結論から言います。Animaを扱うなら、「盛る」という考え方を一度完全に捨ててください。
Animaで「盛る思考」を押し通そうとすると、無駄な時間と労力を消費し続けることになります。
Animaに必要なのは「盛る」ことではなく、「生成のクセを掴み、制御する」ことです。
次項からは、その制御について詳しく語っていこうと思います。
Animaを制御するとは?
実際にAnimaを触ったことがある方なら痛感していると思いますが、Animaは相当な「暴れ馬」です。
それもただ荒削りなだけでなく、驚くほど繊細な暴れ馬だからこそ、扱いが非常に難しいです。
特に難易度が高いのが、先ほども触れたアップスケールです。ここは他のモデルとは比べものにならないほど挙動がシビアで、少し設定を外すだけで絵が破綻します(これについては後ほど詳しく解説します)。
Animaを制御するとは、その強い主張を抑え込み、こちらの意図通りに動かすために、
- プロンプトの記述構造
- LoRAの強度調整
- サンプラーとスケジューラの選択・調整
- アップスケール時のステップ数とDenoise調整
これらを緻密に噛み合わせることです。
少々面倒に感じるかもしれませんが、まずは僕の書いた通りに一度試してみて、その「感覚」を掴んでみてください。
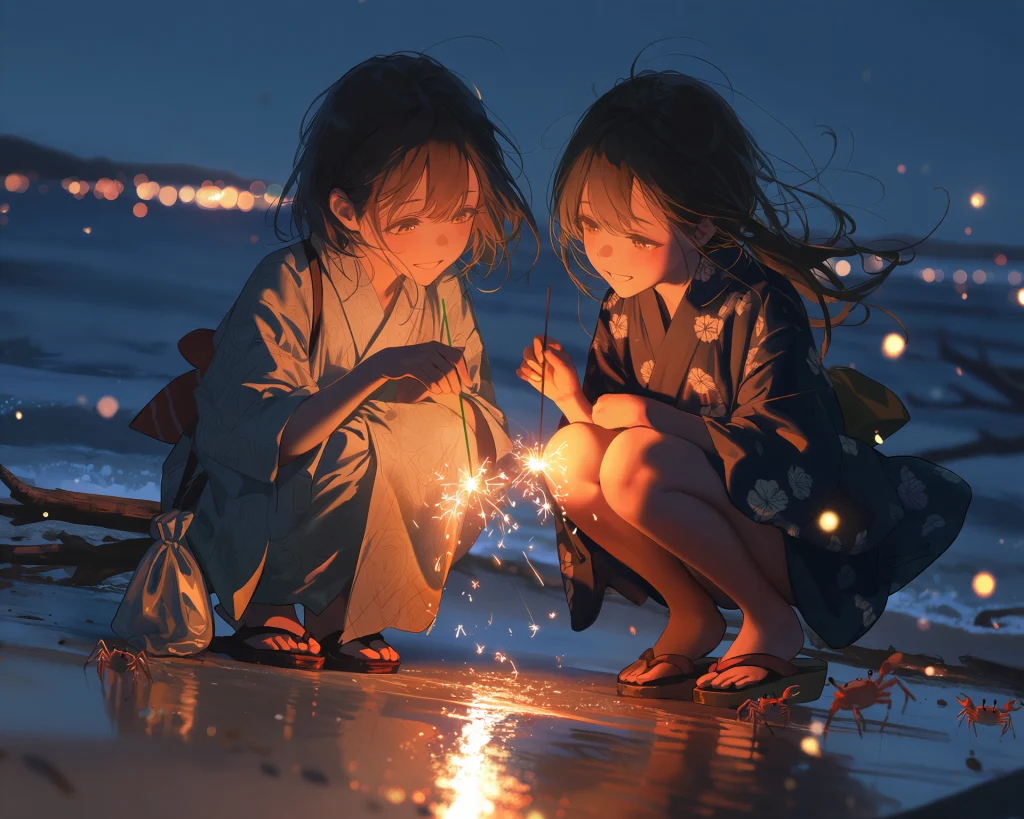
このイラストは僕がAnimaのクセを掴み始めた、ちょうど3ヶ月前のイラストです。
アップスケールはしていませんが、プロンプト・LoRA強度・サンプラーとスケジューラを調整し、初めてじゃじゃ馬のAnimaをうまくコントロール出来た思い出の作品です。
アップスケールしてみようと思ったらpngファイルが行方不明で出来ませんでした(._.)
Animaのプロンプト記述について
画像生成AIにおいて最も重要な土台はプロンプトです。Animaにおいてもそれは変わりません。
従来のSD1.5やSDXLでは、カンマで区切った「Danbooruタグ」を羅列してプロンプトを組むのが常識でした。 AnimaでもDanbooruタグ自体はもちろん有効です。しかし、Animaはテキストエンコーダーに「Qwen」を採用しています。
Qwenは非常に高い言語理解力と推論力を持っています。そのため、Danbooruタグの単語だけをぶつ切りで放り込むと、AI側が「前後の文脈」や「ユーザーが本当に意図した関係性」を正確に解釈できず、結果として勝手に解釈を広げて暴れてしまいます。
そこで重要になるのが、「自然言語(文章)」の導入です。
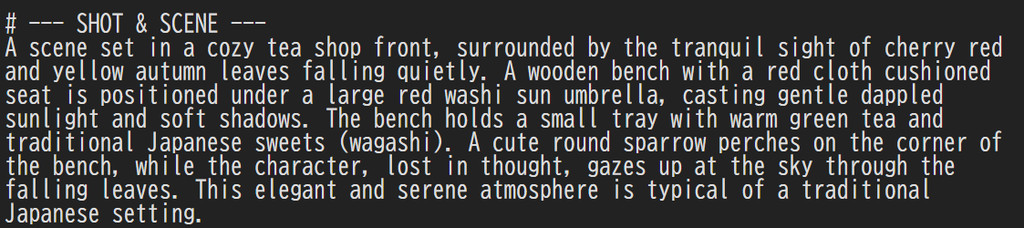
Qwenは自然言語を深く理解するため、「誰が・どこで・何をしているのか」という状況の文脈を自然な文章で受け取ることで、初めてユーザーの狙いを正しく汲み取ってくれます。
「自然言語(動的)」と「Danbooruタグ(静的)」のハイブリッドが最強の鍵
では、Danbooruタグを捨ててすべて英語の長文にすれば良いのかというと、実はそうではありません。
ここがAnimaの最も面白く、奥深いポイントです。
Animaを完全に乗りこなす秘訣は、役割分担によるハイブリッド記述にあります。
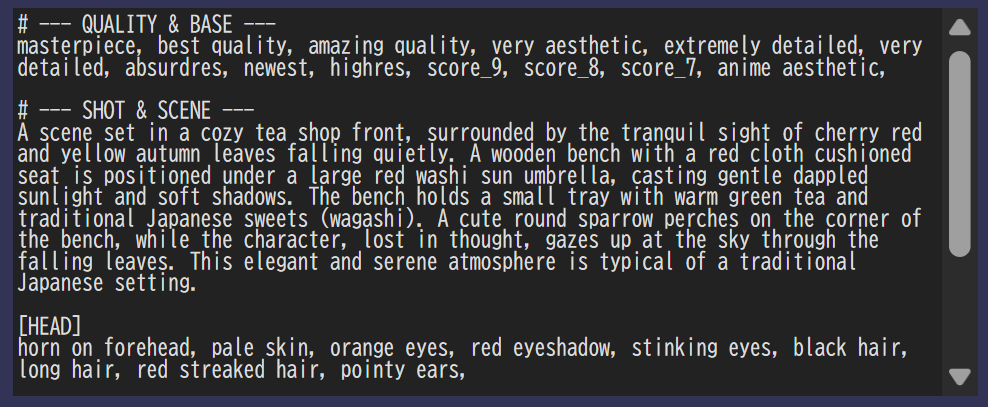
- 【自然言語】=「動的なもの」を担当させる
- キャラクターのポーズ、視線、表情、アングル、空気感、ライティング、アクションなど。
- 「右手を前に突き出し、挑発的に微笑みながらこちらを見つめている」といった動的な動き、関係性は自然言語で書くことで、劇的に破綻が減ります。
- 【Danbooruタグ】=「静的なもの」を担当させる
- 衣装のパーツ、髪型、装飾品、目の色、具体的なアイテム名など。
- 「corset」「silver hair」「blue eyes」「pleated skirt」といった固定の形状・属性・パーツ定義は、Danbooruタグで明確に指定する方が圧倒的にブレません。
文脈やポーズといった「流れ(動)」は自然言語でQwenにスマートに伝え、揺らいでほしくないパーツや属性(静)はDanbooruタグでガチッと固定する。
この「動的な自然言語 × 静的なDanbooruタグ」の組み合わせこそが、Animaの暴れ馬な性質をねじ伏せ、思い通りのイラストを生み出すための最大の武器になります。
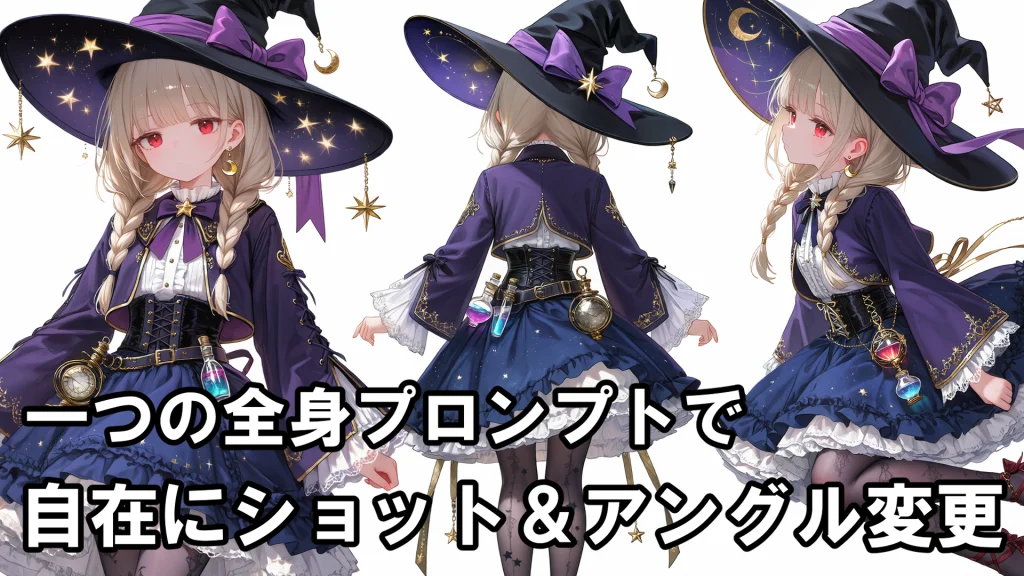
僕が制作したカスタムノード「Anima Prompt Director」は、まさにこの理論に基づいて開発しました。
キャラクター設定の全身プロンプトから指定部位のDanbooruタグ(静的な要素)を抽出し、LLMによって日本語で入力した表情やポーズ、シチュエーションなどの文脈(動的な要素)を自然言語へ自動変換して、世界観にマッチしたシチュエーションを肉付けするツールです。
僕の自作ノードの中でも最高傑作で、プロンプト面ではこれさえ使っていれば間違いないと断言できます。
ただし、便利なツールに丸投げするだけではなく、「なぜそのプロンプト構成にするのか」という本質を理解する事が何より大切なので、そこは忘れないようにしてくださいね。
興味がありましたらコチラの記事をご覧下さい。
LoRAについて
プロンプトの次に初心者がぶち当たる巨大な壁が、LoRAです。ここは本当に多くの人が沼にハマるポイントです。
皆さんは「LoRA」と聞くと、どのような役割をイメージするでしょうか? おそらく多くの方は「絵を豪華に盛るためのもの」「劇的に変化させるためのもの」と捉えているはずです。
もちろん、従来であればその認識で問題ありませんでした。しかしAnimaにおいては、そのアプローチは危険です。
僕の考えるAnimaにおけるLoRAの役割は、「補完と調整」です。
絵を変化させるのではなく、モデル単体ではわずかに届かない要素を補い、質感や陰影のディテールをそっと整えるために使います。
この考え方を持つことで以下のような大きなメリットが生まれます。
- あれもこれもと無駄にLoRAを重ねて迷走しなくなる
- 自分が本来創りたかったイラストの軸がブレなくなる
- 絵の軸が固まるため、細部のクオリティ調整に集中できる
- サンプラーやステップ数など、生成の内部挙動に対する理解が深まる(後述)
AnimaでLoRAを盛ると何が起きるのか?
Animaはベースモデル自体の表現力と画力が極めて高いため、LoRAの干渉を非常に敏感に拾ってしまいます。
強すぎるLoRAはAnimaの強みである繊細なタッチやプロンプト追従性を上書きしてしまい、結果として「LoRAのクセが全面に出た硬い絵」や「過剰なサンプリングによるノイズまみれの絵」になってしまうのです。
そしてそれを補う為に新たなLoRAを使ってしまうなど悪循環に陥ってしまいがちです。
LoRAで固めるのではなく、モデルの良さを活かし、足りない要素をLoRAでそっと補いながら生成する事がクオリティアップのコツです。
AnimaにおけるLoRA強度のルール
- LoRAの強度は「0.3〜0.5」からスタートする
従来は0.8〜1.0で扱っていたLoRAであっても、Animaでは0.3〜0.5を目安に設定します。「そんなに低くて効果があるの?」と思うかもしれませんが、十分に機能します。むしろ「言われてみれば背景が締まった」「金属のハイライトが少し際立った」と感じるくらいの控えめな強度が、Anima本来の美しさを損なわないベストバランスです。
僕はディテール・ライティング関連のLoRAを複数個使用していますが、全て0.25~0.4の範囲です。 - 「足し算」ではなく「調味料」として使う
背景を少し緻密にしたいなら背景ディテール系LoRAを0.4、光の陰影を強調したいならライティング系LoRAを0.35というように、あくまでベースはAnimaに任せ、足りない要素だけを調味料としてLoRAを使うという考えが良いと思います。 - LoRAを足す前に、まずプロンプトを見直す
「イメージ通りに出ないからLoRAを足そう」と安易に考えるのは一番危険です。LoRAが増えるほど後の工程の制御が困難になります。
モデルが本来出せない要素をLoRAで強制するようなものなので、制御が出来なくなるのは当然です。
まずは前項で解説した「自然言語×Danbooruタグ」で骨組みを作り、サンプラーやスケジューラーの調整をし、それでも補えない場合にのみLoRAを頼るようにしてみてください。
LoRAは便利ですし、その手軽さ故に事故の要因になっているとはなかなか気付かないものなのですよ( ´-`)
サンプラーとスケジューラーの選択と調整
サンプラーとスケジューラーの組み合わせは仕上がりの好みが分かれる部分でもあるため、「これを使え!」とは言いません。
しかし、Animaを扱う上で一つだけ断言できることがあります。 それは、「サンプラーとスケジューラーの特性を理解しておくことが、何よりも重要」ということです。
完璧に数式レベルで理解する必要はありません。「大雑把な手触り」を把握していれば十分です。
「このサンプラーは絵をシャープにするのか、それとも柔らかくまとめるのか」 「このスケジューラーは前半に大きく形を作るのか、後半まで粘り強くディテールを詰めるのか」
この特性さえ頭に入っていれば、特に後のアップスケール工程で絵が崩れたり思っていた質感と違ったりしたときに、迷うことなく軌道修正できるようになります。 ここでは、Animaで特によく使われる代表的なサンプラーとスケジューラの特性、そして組み合わせをまとめました。
代表的なサンプラーの特性
- euler 系(euler / euler_ancestral)
- 特性: 最も基本的かつ素直な挙動をするサンプラー。
- 描き味: 線の輪郭が柔らかく、アニメ調のすっきりしたセル画風・クリーンな作風に向いています。
- 注意点: 素直で破綻が少ないサンプラーですが、全体的に均一な描画で個性を出す場合は物足りなく感じる。ちなみに読み方はオイラー。自信満々にエウラーと叫ばないように注意。
- heunpp2
- 特性:高精度で破綻しにくい高品質サンプラー。eulerの完全上位互換という認識でOKです。
- 描き味: クセがなく線のまとまりが良く、コントラストや色の階調が非常に滑らかで上品に仕上がります。
- 注意点: 1ステップあたりの計算コストがeulerの2倍近くかかるため、生成速度は遅いです。じっくり1枚の完成度を高めたいときに適しています。アップスケール時に使う場合はお風呂に入りましょう。
- dpmpp_2m_sde_gpu
- 特性: DPM-Solver++にSDE(確率微分方程式)の揺らぎを加えた定番サンプラー。
- 描き味: 細部の描き込みが得意で、情報量の多い絵を仕上げるのに優れています。
- 注意点: ステップ数やDenoise値を高くすると、Animaでは輪郭が過剰にジャギったり、ノイズが浮き出たりしやすいサンプラー界の暴れん坊将軍です。
- er-sde
- 特性: 拡散モデルの確率的ノイズを極めて繊細にコントロールするSDE系サンプラー。Animaと抜群の相性を誇ります。
- 描き味: 肌の滑らかなグラデーション、髪の毛の細い束感、空気中の光の拡散など、絵画的なリッチな質感を破綻させずに引き出すのが得意です。
- 注意点: スケジューラーとの相性が強く出るため、後述の
betaやbeta57など、ノイズ減衰が滑らかなスケジューラーと合わせるのが基本になります。
参考程度に僕は、ほとんどの工程でer-sdeを使い、部位毎の最終仕上げの調整にeulerやheunpp2を使っています。
ここぞの一撃という時によくdpmpp_2m_sde_gpuを使ったりしますが、大体は失敗に終わります。
代表的なスケジューラーの特性
スケジューラーは、「全ステップの中で、どのタイミングでどれくらいノイズを除去していくか」の配分を決める役割を持ちます。
- simple
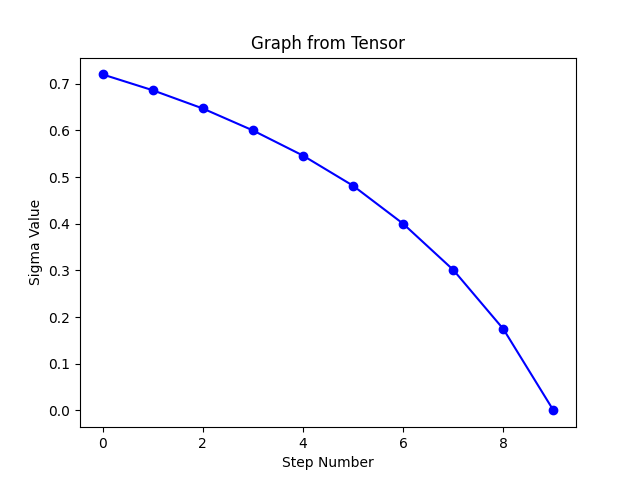
- 特性: 均等にノイズを減らしていく、最も標準的なスケジューラー。
- 挙動: 癖がなく扱いやすいですが、後半の微細な質感調整の粘りがやや弱く、Animaのポテンシャルを極限まで引き出すには少し物足りない場面があります。
- sgm_uniform
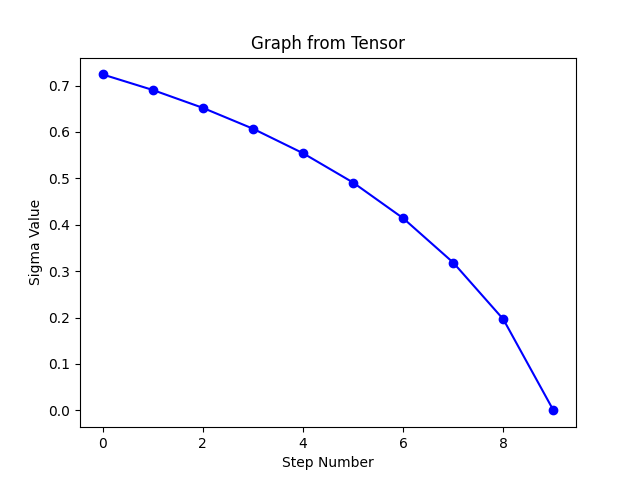
- 特性: simpleに似た均等寄りのステップ配分を行い、終盤に一気に畳み掛ける安定系スケジューラー。
- 挙動: 構図やポーズの崩れを本当に強力に防ぎます。仕上げ段階など、「すでに決まった形を崩さずに表面の解像度だけを上げたい」場面で非常に頼りになりますが、まとまりすぎてつまらないイラストになる危険がある為、Denoiseには気を付けて使用すべきスケジューラー。副作用がある万能薬という表現がぴったりです。抗生物質ですね。
- beta
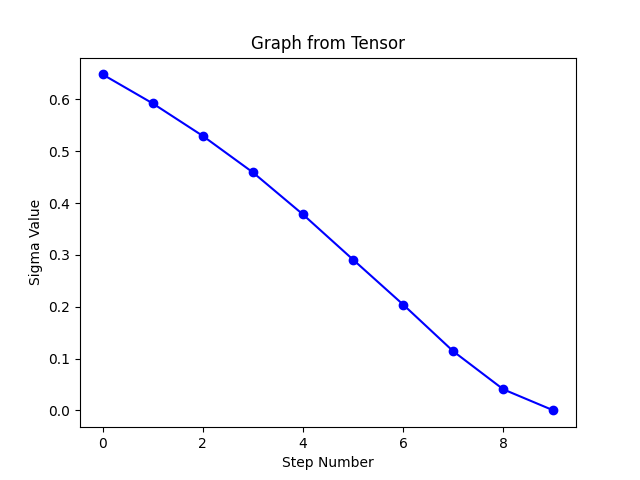
- 特性: 前半で大まかな形を完成させ、中盤〜後半にかけてじっくりと時間をかけてノイズを取り除くカーブを描きます。
- 挙動: 細部のテクスチャや光のハイライト、瞳の描き込みが非常に繊細に仕上がります。Anima特有の「リッチな塗り」を作りたいときに
- beta57
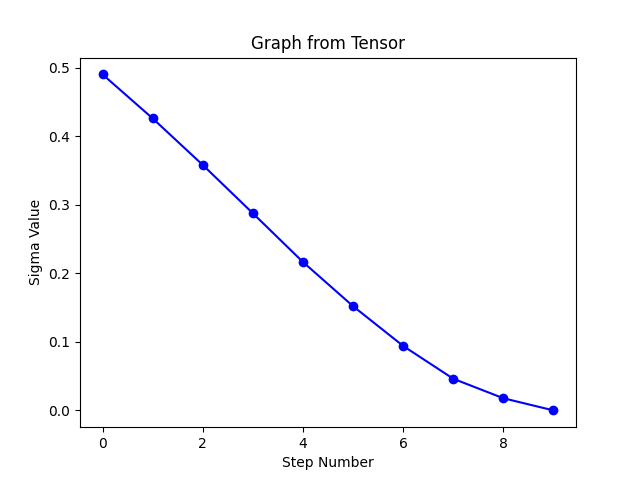
- 特性: betaのノイズ除去スケジュールをさらに最適化し、低ステップ(16〜20前後)でも破綻せず高密度な出力を可能にしたカスタムスケジューラー。カスタムノードRES4LYFをインストールする事により使えるようになります。
- 挙動: 高速化LoRAなどを併用した短いステップ数でも、輪郭がボケずにシャープなディテールを出してくれます。クセが強いスケジューラーですが、その特性を乗り越えた先に花園有り(実体験)
ちょっと難しい言い回しをしてしまいましたが、派手な事をさせたくない工程ではsimple、派手に暴れさせたければbetaかbeta57、最終仕上げのsgm_uniformと覚えておけば大丈夫です。
僕はベース工程ではステップ数30のbeta57で大暴れしてもらい、Hires.Fix1ではbetaかbeta57でちょっと暴れてもらい、Hires.Fix2ではsgm_uniformで落ち着かせています。
そしてDetailer工程ではクセを出さずにディテールを調整する為にsimpleにして調整しています。
betaはノイズ曲線を見ると分かりやすいですが、最初に大雑把に形を決めてネチネチと細かいノイズ除去を行うスケジューラーなのでディテール力が強い反面雑な箇所が残る特性があります。
beta57がまさにその代表格で、中ステップ以上で扱う事で非常に美しいディテールを作り出しますが、後のアップスケールで泣きを見る程の遺恨を残します。
美しいディテールを作り出すが巨大なウ●コを複数残して去っていくイメージです。
僕がアップスケールで1ヶ月頭を悩ませた犯人がこいつです。
beta57はクセが強く本当に扱いが難しいスケジューラーですが、僕はこのbeta57をベース生成の全ての中心に据えて構築しているほど絶対的な信頼を置いてるスケジューラーなので、皆さんも良かったら体験してもらえたらなと思います。とても勉強になりますよ(・∀・)ニヤニヤ
おすすめの組み合わせの考え方
- アニメ的で透明感のある柔らかい絵柄にしたい場合:
euler×simple(またはsgm_uniform)
- リッチな質感、光の表現を極限まで追い込みたい場合:
er-sde×beta(ステップ数 25〜30前後)
- 高速化LoRAを使いつつ、短ステップで高密度に仕上げたい場合:
er-sde×beta57(ステップ数 16〜20前後)
まずはこの3パターンのうち、自分の目指す絵柄に近いものを一つ選んでみてください。
生成難易度は順列通りです。
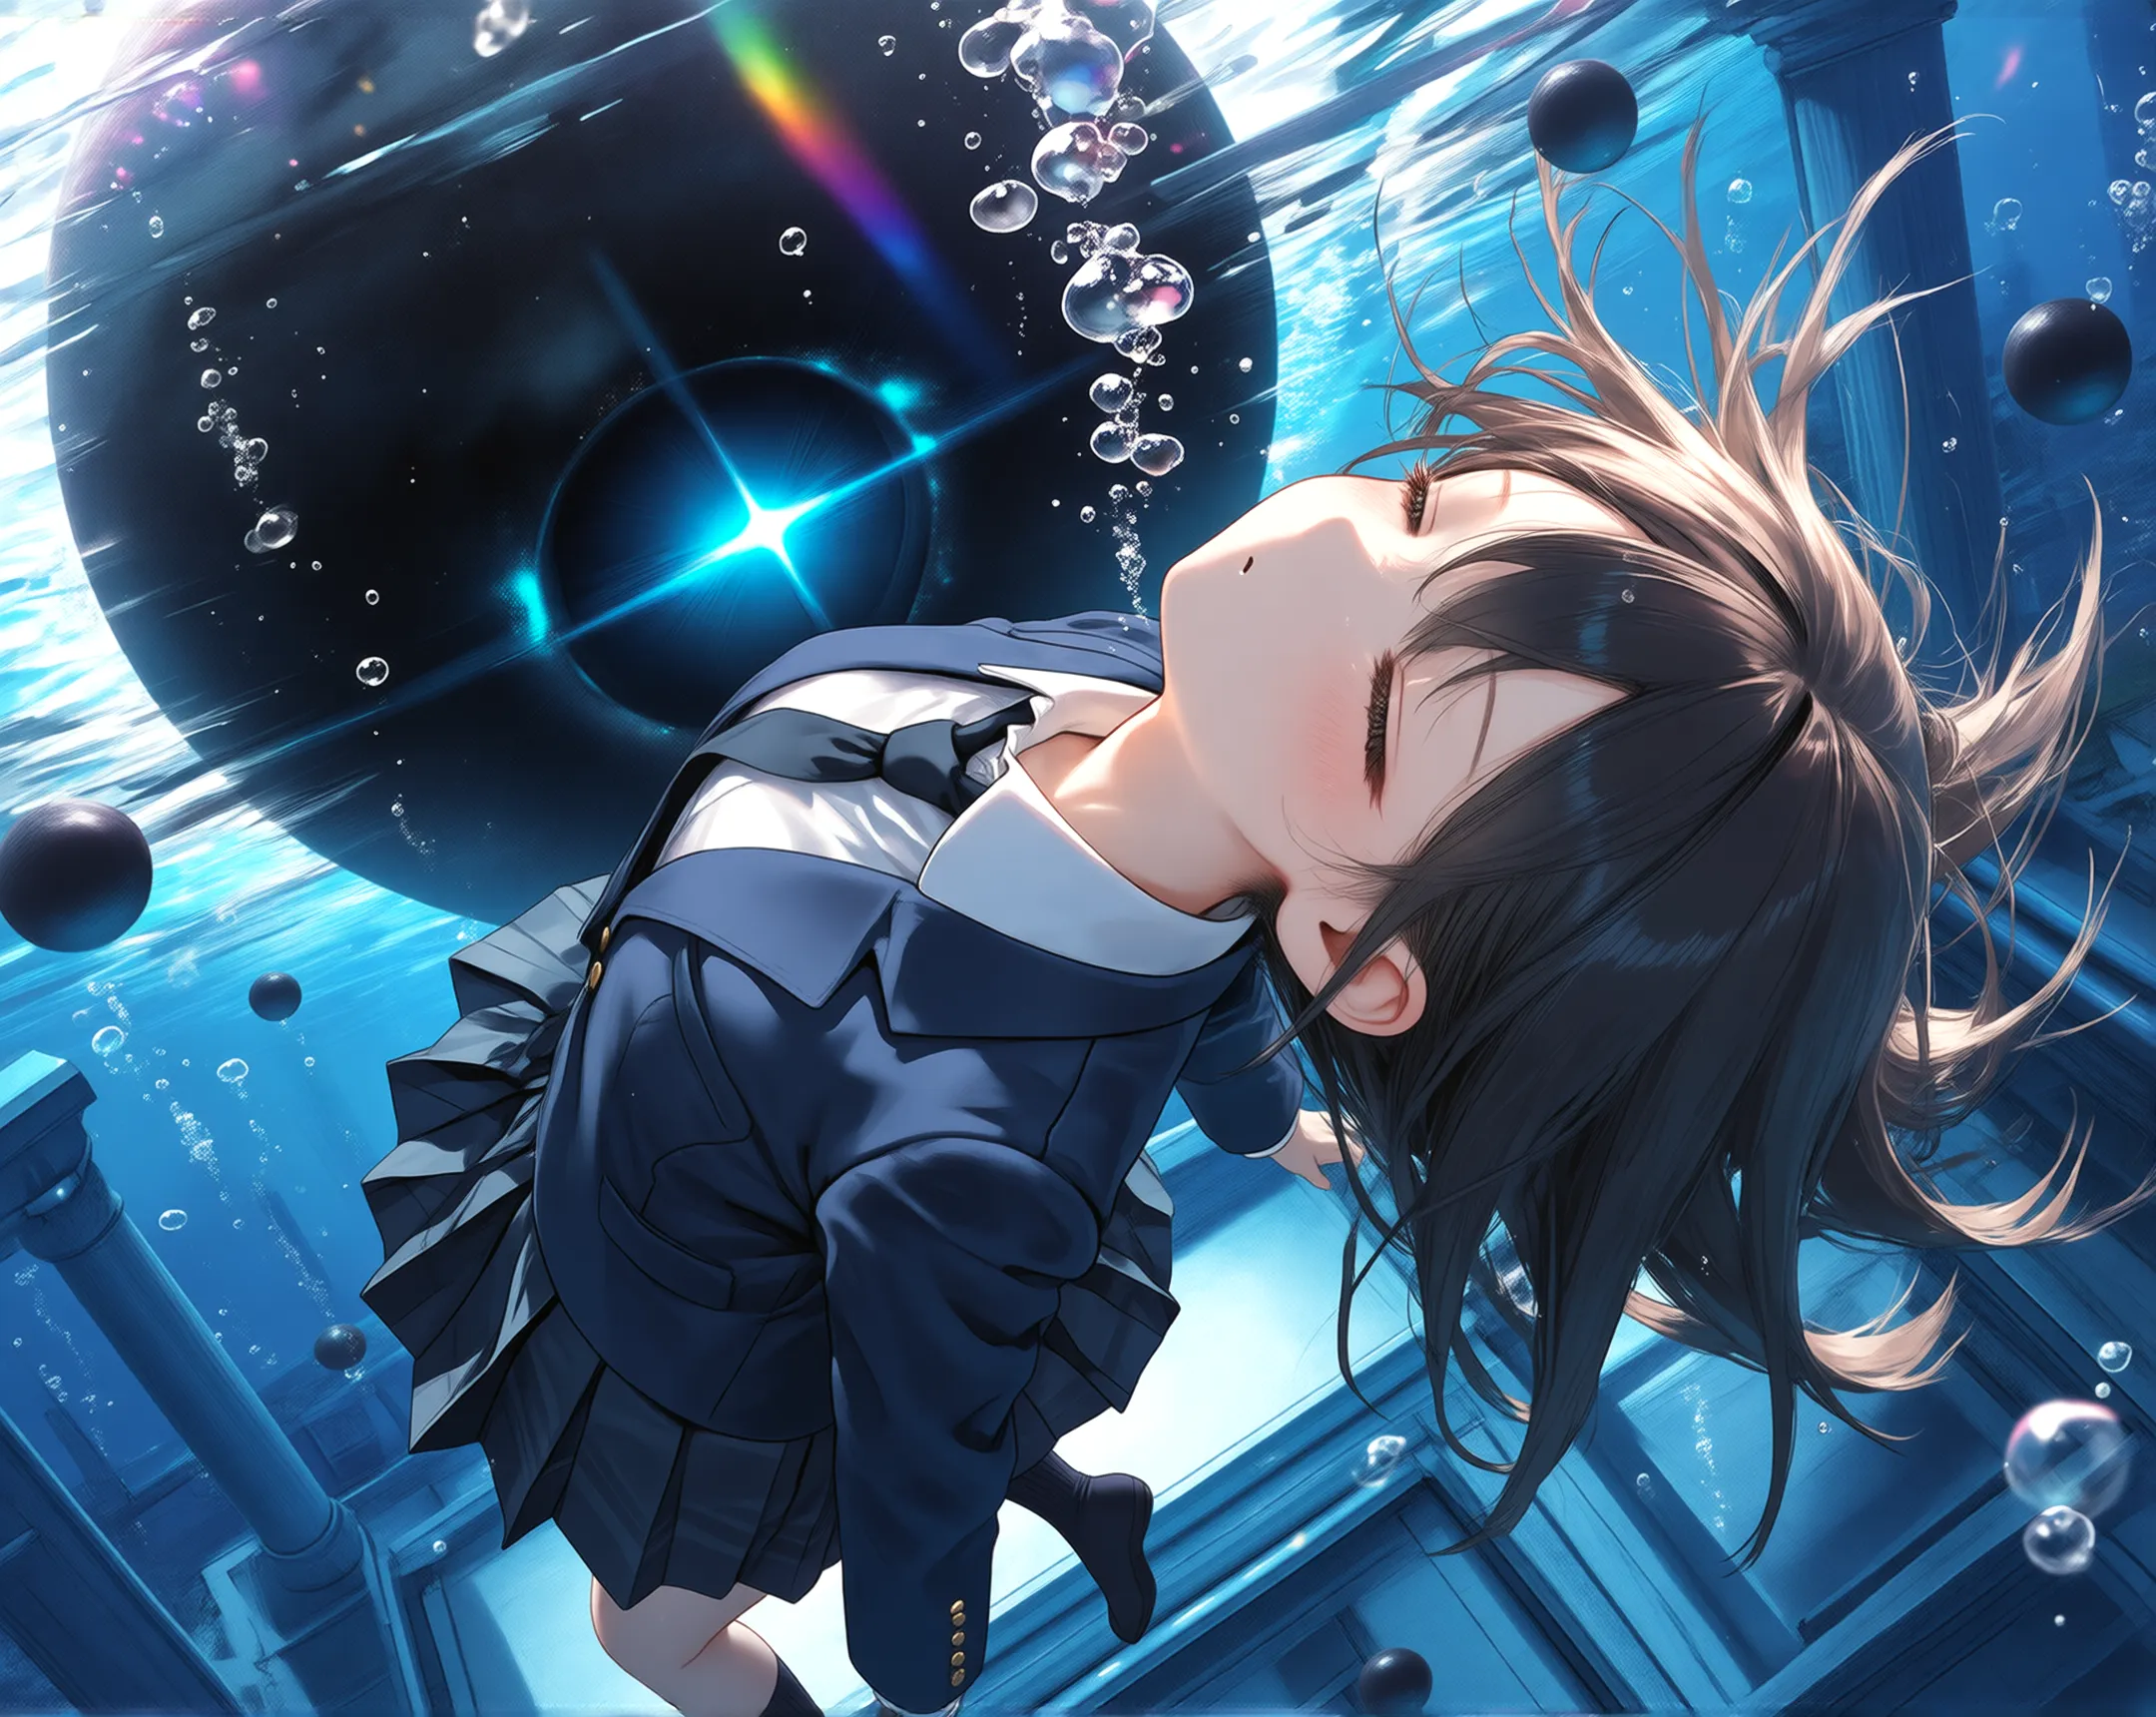
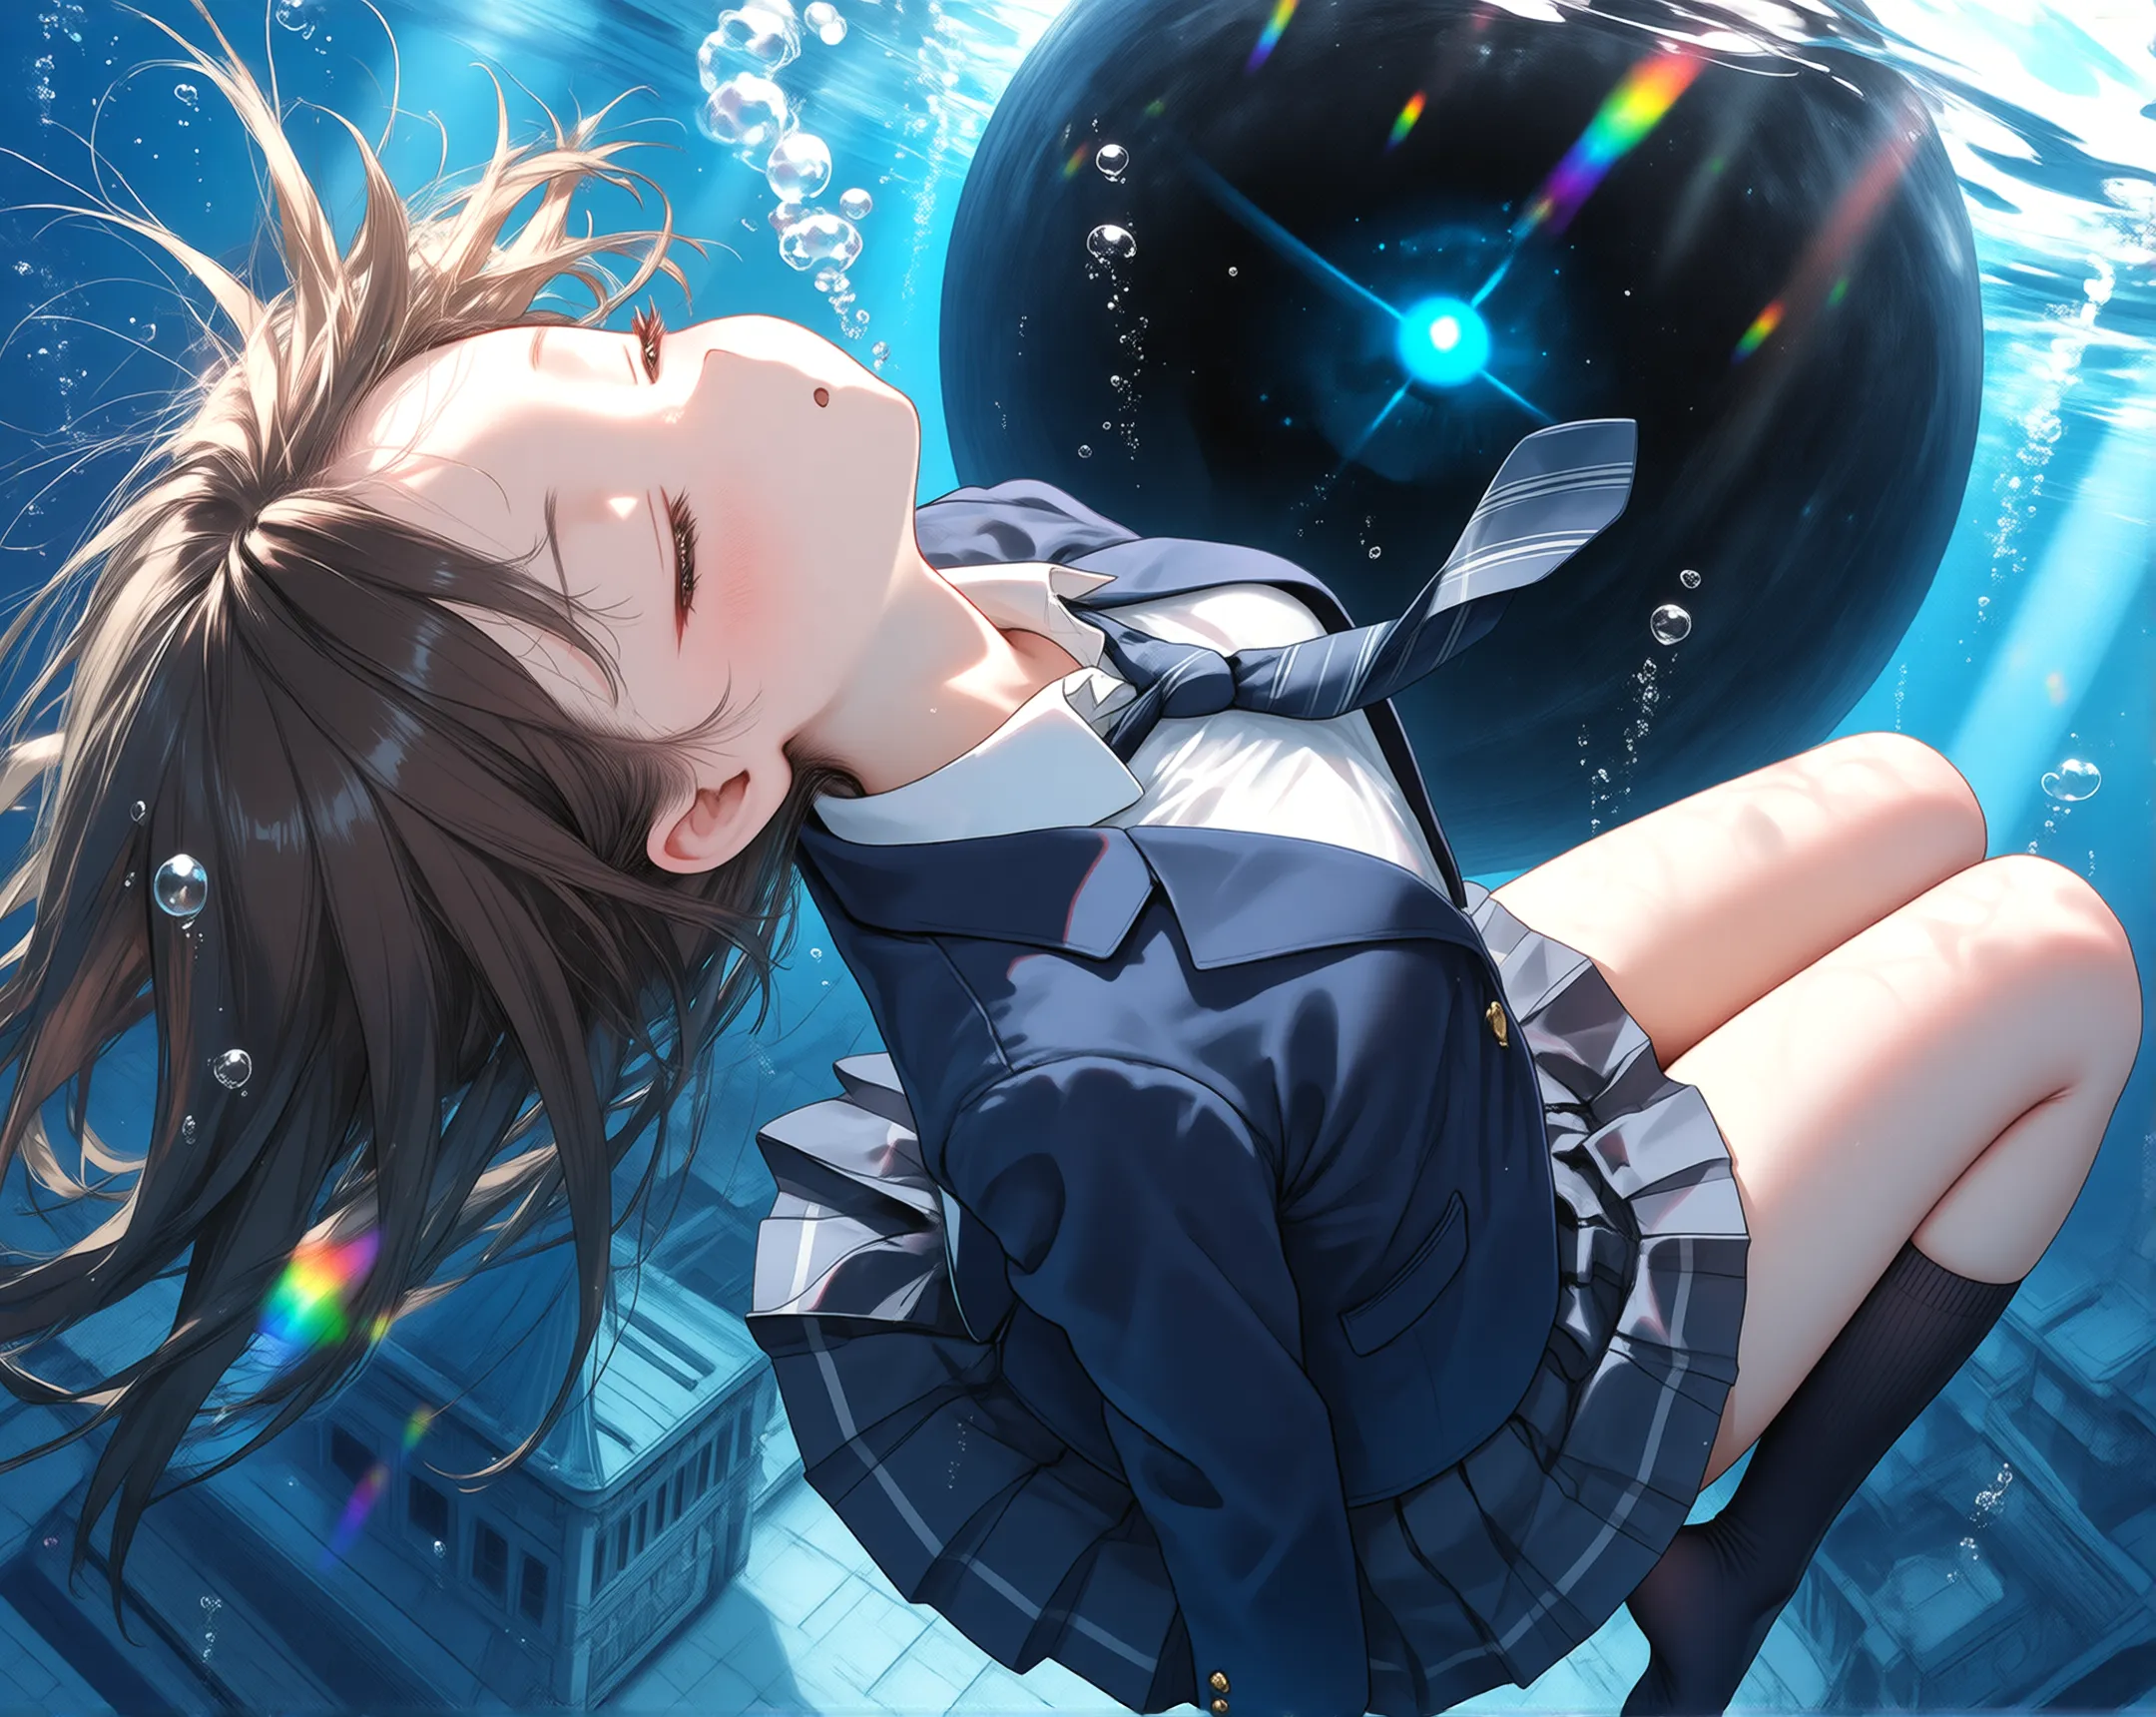
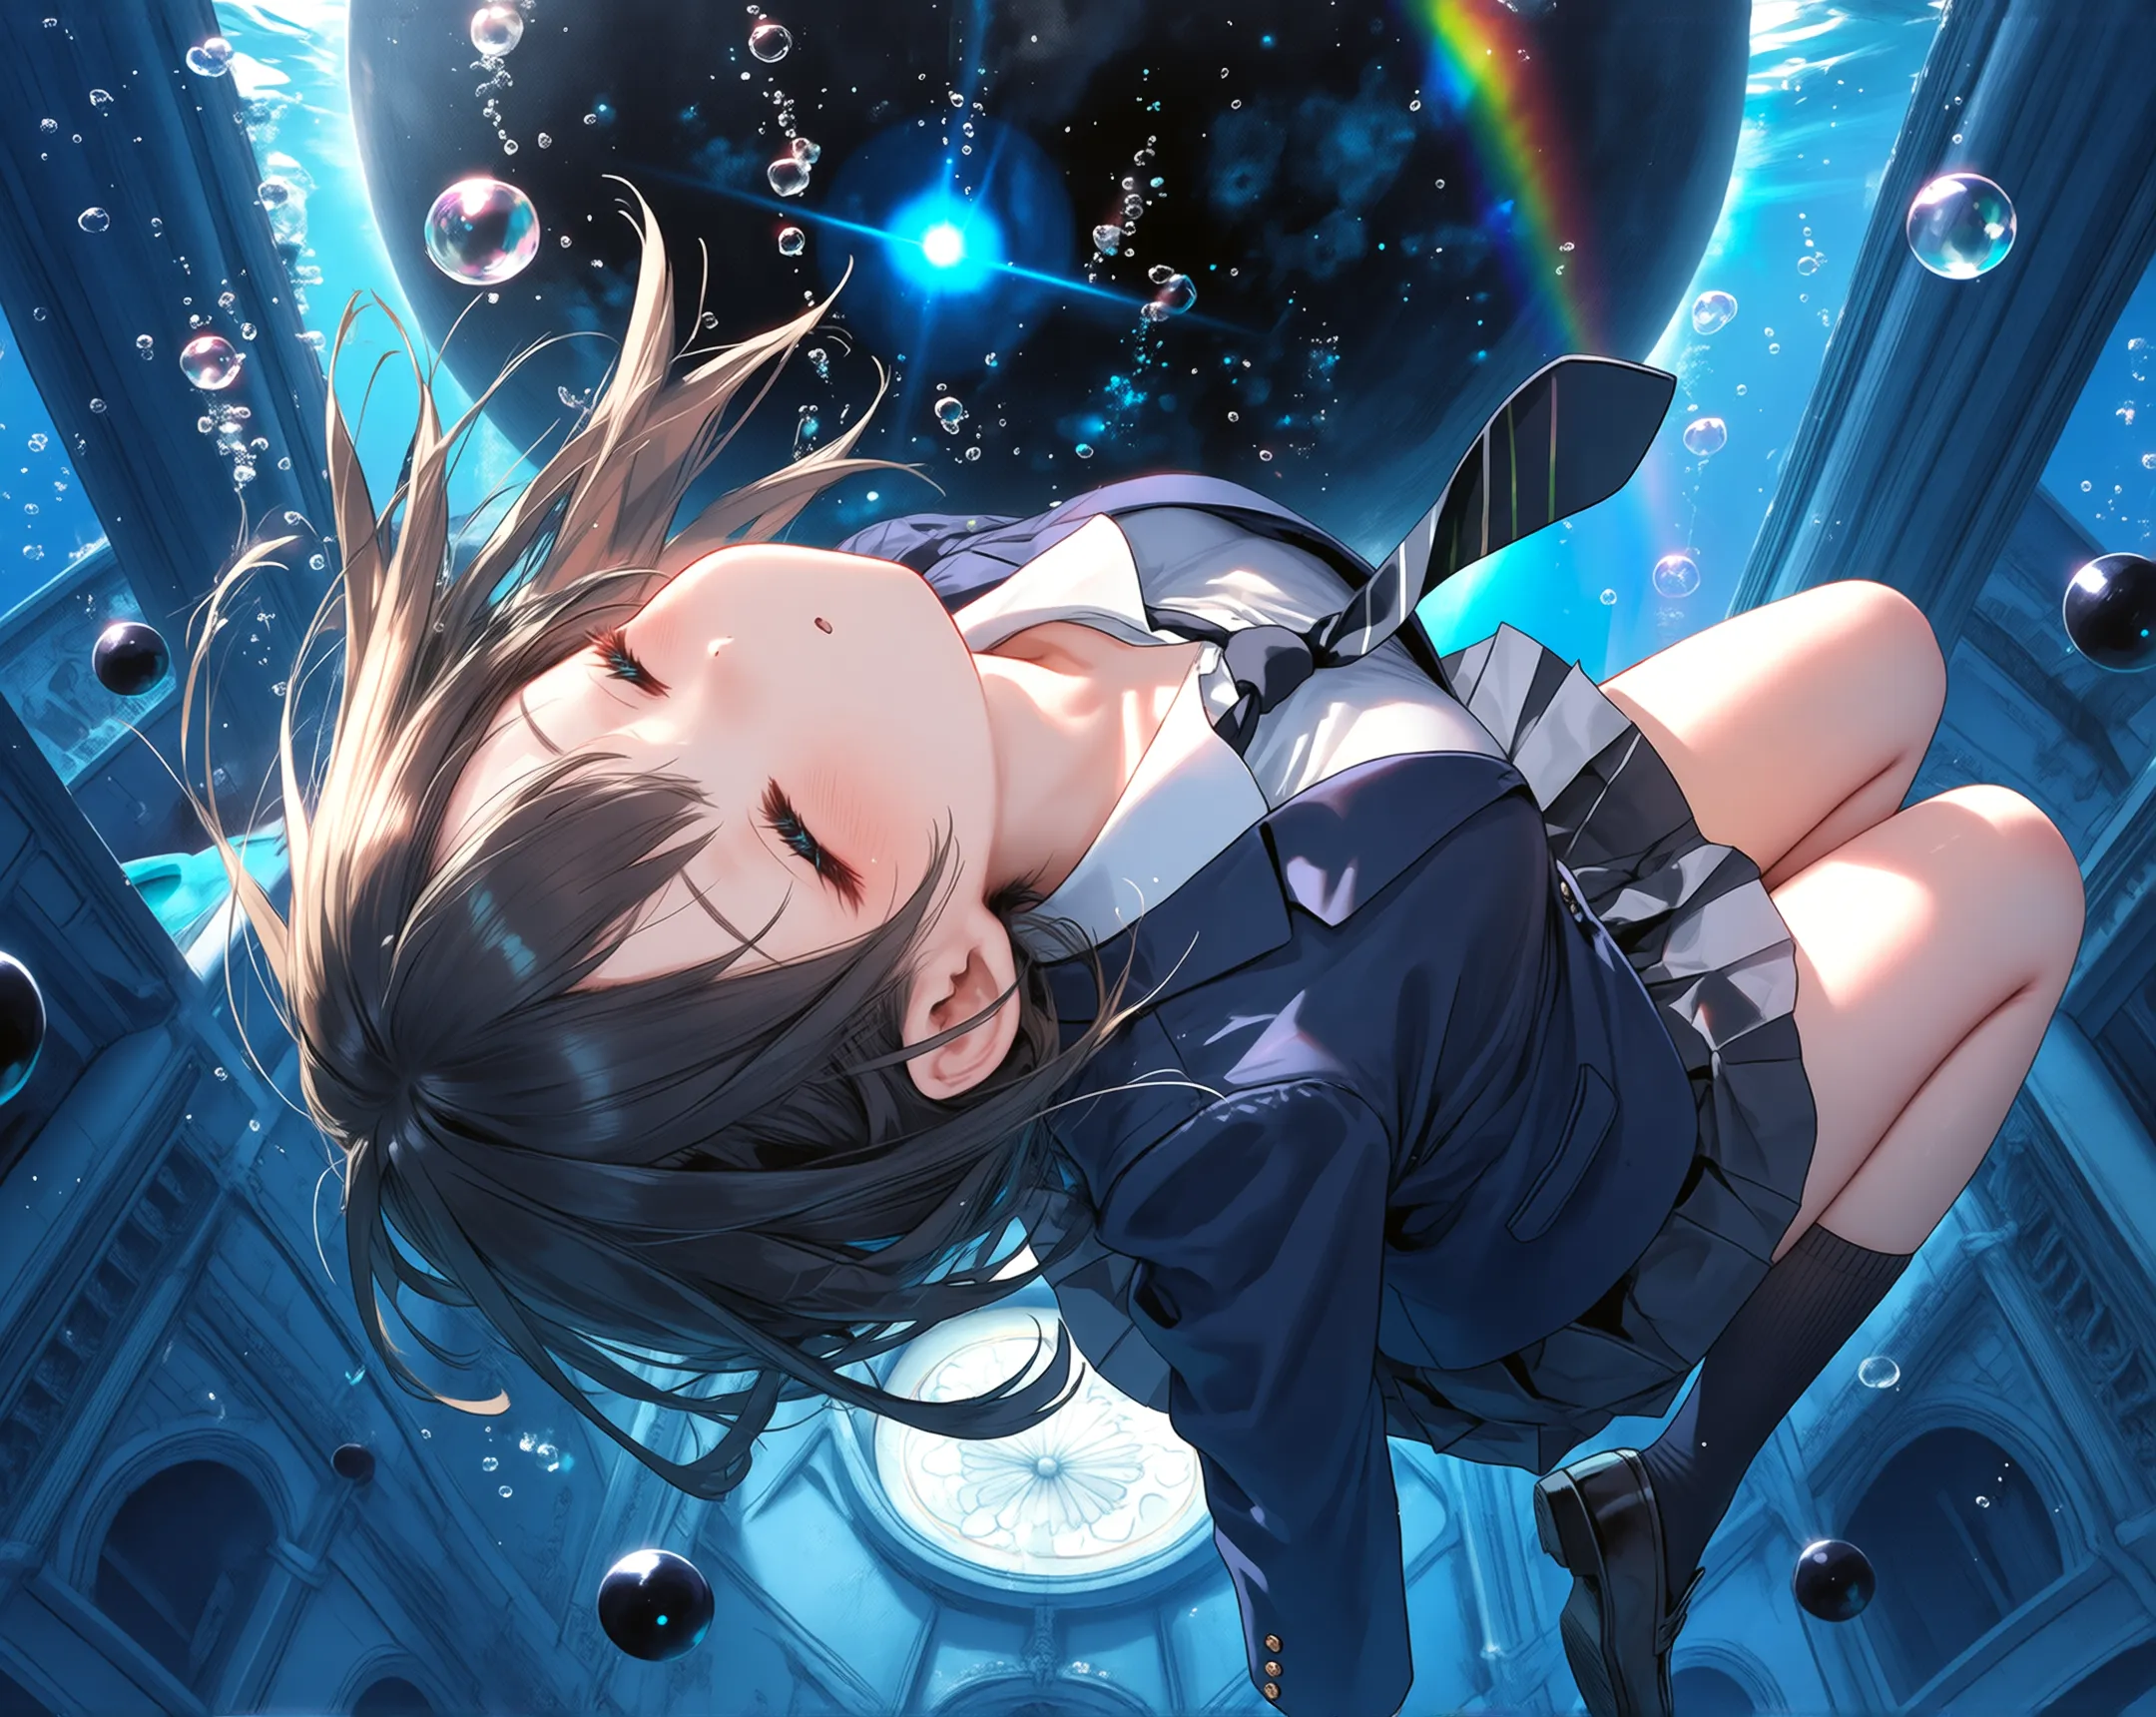
以下はベース生成を上記の3パターンで生成した結果で、Seedを固定しステップ数は30で固定、アップスケールは全て同条件のものです。
【euler × simple】
【er-sde × beta】
【er-sde × beta57】
Animaのアップスケールについて
いよいよ本丸です。
アップスケール、ここがAnimaにおける最大の沼であり、最も分厚い壁です。
アップスケールには唯一絶対の正解がありません。モデルの相性、狙う絵柄、PCスペックによってもアプローチが千差万別だからこそ、誰もが手探りで迷走し、「こうすればOK」と一言で言い切ることができない領域です。
だからこそここでは、僕が丸1ヶ月思い悩み、何千枚もの試行錯誤の末に辿り着いた「僕の中での絶対的最適解」というものを紹介します。
なぜAnimaはアップスケールで崩壊するのか?
従来の画像生成AIではベース画像を「1.5倍〜2.0倍」に一気に引き伸ばし、Denoise 0.4〜0.5程度で強引に描き込ませるアプローチが通用しました。
しかし、これをそのままAnimaでやると、ほぼ100%の確率で絵が崩壊します。
キメラが生まれたり、顔が二重になったり、指が増えたり、線画が溶けてノイズにまみれたり…etc
その理由は、Animaというモデルが持つ圧倒的な解像度への繊細さにあります。
一度に巨大なサイズへ引き伸ばしてしまうと、その後のRefine処理において「新たに埋めるべきノイズの面積」が一気に膨れ上がります。
繊細すぎるAnimaは過剰に反応してしまい、「どこを描き足せばいいのか」のバランスを見失い、余計な線やパーツを画面中に勝手に生やしてしまうのです。
解決の鍵は低倍率を重ねる「2段階Hires.Fix」
この過剰反応を抑え込み、元の構図や美しい顔立ちをミリ単位で維持したまま解像度だけを極限まで引き上げる手法。
それこそが、「低倍率での段階的アップスケール(Hires.Fix × 2回)」です。
Hires.Fix(ハイレゾフィックス)とは、生成した画像を一度拡大(リサイズ)した上で、再度サンプリング(i2i / Refine)をかけて細部の解像度や描き込みを補う手法のことです。
僕のワークフローでは、一度に大きく引き伸ばすのではなく、Hires.Fixを2回に分けて実行しています。
- ベース生成(例: 1280×1024)
- Hires.Fix 1:倍率 1.3倍(Denoise: 0.2〜0.3)
- Hires.Fix 2:さらに 1.3倍(Denoise: 0.2〜0.25)
1回の拡大倍率を「1.3倍」という控えめな数値に抑えることで、画像の歪みやボケを最小限にとどめ、Animaが迷わない状態をキープすることができます。
ステップ数は「ベース生成時の約◯%」に削ぎ落とす
そして、僕の最適解の中で最も重要かつキモとなる数値設計が、「Hires.Fix時のステップ数」です。
多くの人は「アップスケールするのだから、ステップ数もベース生成と同じか、それ以上に多く回すべき」と考えがちです。しかしAnimaにおいてそれは致命的なミスになります。高解像度での過剰なステップ数は、描き込みを増やすのではなく、絵を硬くし、ノイズを焼き付ける原因にしかなりません。
僕のワークフローでは、Hires.Fix時のステップ数を「ベース生成時の約30%」という極めて低い数値に自動計算をさせています。
- ベース生成が 30ステップ なら ➔ Hires.Fix は「9ステップ」
- ベース生成が 16ステップ(高速LoRA時)なら ➔ Hires.Fix は「5ステップ」
「たった9ステップで本当に描き込めるの?」と不安になるかもしれません。
ですが、これで完璧に仕上がります。
1.3倍という無理のない拡大率と、0.2〜0.3前後の低いDenoiseに対して、わずか数ステップだけサンプラーをくぐらせる。 こうすることで、元の美しいタッチやキャラクターの顔立ちを一切崩すことなく、拡大によって甘くなったエッジだけをキュッと引き締め、微細なハイライトやディテールだけを滑らかに定着させることができるのです。
「大きく引き伸ばしてゴリゴリ描き直す」のではなく、「薄皮を一枚一枚重ねるように、わずかな拡大と最小限のサンプリングを丁寧に通す」。
この段階的アップスケールを実践するだけで、今まで悩んでいたAnimaの破綻やノイズが嘘のように消え去り、驚くほど緻密でクリアな「最高の1枚」に出会えるはずです。
更にこだわるならこの拡大法:モデルに頼らない「純粋リサイズ」の極意
これまではHires.Fixの「Refine(描き足し・ノイズ除去)」の設定に焦点を当ててきましたが、ここからはその前段にあたる「アップスケール(拡大処理)」そのものについて掘り下げていきます。
通常、ComfyUIやWebUIで画像を拡大する際、ほぼ100%に近い方が「4x-UltraSharp」や「4x-AnimeSharp」「4x_NMKD-Superscale」といったAIアップスケールモデル(アップスケーラー)を使っているはずです。
しかし僕のワークフローでは、AIアップスケールモデルを一切使わない拡大方式を採用しています。
なぜアップスケールモデルを使わないのか?
アップスケールモデルは、低解像度の画像を「AIが推測して線やテクスチャを補完しながら拡大する」仕組みです。
一見すると便利で高精細に見えますが、Animaにおいてはこれが仇となると僕は考えます。
- 元の絵のタッチを崩してしまう:ベース生成で納得のいく「繊細な線の細さ」や「淡い透明感」のイラストがアップスケールモデルを通すことで太い線に描き直されたり、クッキリしすぎて硬い質感に変わってしまいます。
- アップスケーラー特有の「クセ」が混ざる:モデルごとに固有のノイズ処理やシャープ化のクセがあるため、Anima本来の美しい色調や塗りのニュアンスが濁ってしまいます。
僕がやりたいのは「別のAIモデルに絵を描き直させること」ではなく、「ベース生成で生まれた最高の絵のまま、解像度だけを大きくして次のRefineへ渡すこと」です。
辿り着いた最適解は「DaSiWa Torch Resize」によるリサイズ
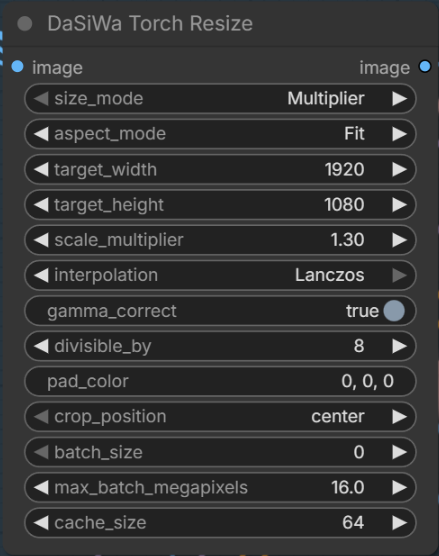
そこで僕が辿り着いたのが、カスタムノード「DaSiWa Torch Resize」を使った拡大手法です。
この方式の最大のメリットは、AIの推測による余計な描き込みを挟まず、純粋なアルゴリズム(Lanczos補間など)によって「元の絵を1ピクセルも変質させずに、そのまま素直に引き伸ばせる」点にあります。
- モデルのクセが一切入らない:余計なテクスチャやコントラストの誇張が入らないため、Animaのピュアな色合いと線画がそのまま保たれます。
- 次のRefine(低ステップサンプリング)が完璧に機能する: 余計なエッジが立っていない状態で1.3倍に拡大されるため、後続のKSamplerが「拡大によるボケ」だけを検知し、狙い通りの微細なディテールアップに全力を注いでくれます。
「高画質化=とりあえずアップスケーラーを通す」という固定観念を捨て、DaSiWa Torch Resize による純粋な拡大 ➔ 1.3倍の低Denoiseサンプリングという流れを組む。 これこそが、元のイラストの魅力を1ミリも損なわずに極限のクオリティへと引き上げる僕の中の最適解です。
ワークフローの配布
HKMC-Anima Workflow v1.6を以下にてダウンロードできます。
今回話した内容の全てがこのワークフロー内にギュッと詰め込んであります。
使う使わないは別として、見るだけでもかなり参考になるのではないかと思いますので、興味があれば是非ダウンロードしてみてください!
v1.6から通常版とLLM版に分かれ、通常版は通常のテキストエンコード(ImpactWildcardEncode)になっています。
LLM版はテキストエンコードが自作ノード「Anima Prompt Director」に差し替わっています。
詳細はダウンロードページをご覧ください。
さいごに
活字ばかりの記事をここまで読んでいただき、本当にありがとうございました。
Animaは、適当にプロンプトを放り込んでボタンを押すだけで誰でも簡単に神イラストが出るような、お行儀のいいモデルではありません。 油断するとすぐに暴れ出し、こちらの意図を軽々と裏切ってくる、実に手のかかる「繊細な暴れ馬」です。
ですが、だからこそ面白い。
- 「動」の自然言語と「静」のDanbooruタグで手綱を握る
- LoRAを盛るのではなく、調味料として薄く重ねる
- サンプラーとスケジューラーの呼吸を合わせる
- AIモデルに頼らず、低倍率の段階的Refineで磨き上げる
ひとつひとつの挙動を理解し、丁寧に制御してあげた瞬間、他のモデルでは絶対に拝めないような鳥肌の立つ「奇跡の1枚」を出してくれます。
その感動を味わったとき、これまでに費やした試行錯誤の苦労はすべて吹き飛ぶはずです。
僕自身、1つのアップスケール設定に丸1ヶ月頭を抱え、何度も挫折しかけました。
この記事が、かつての僕と同じようにAnimaの壁にぶつかり、モニターの前で頭を抱えているクリエイターの皆さんの道標になれば、これ以上嬉しいことはありません。
さあ、理屈はすべて揃いました。 あとはあなたがキャンバスに向かい、あなただけの「最高の1枚」を生み出す番です。
素敵なAnimaライフを!